
SeedVR2 是字节跳动 Seed 团队开源的视频修复模型,有 3B 和 7B 两种大小,Apache 2.0 许可。它用一步扩散模型在新尺寸上把画面重新画一遍,皮肤、头发、砖墙这些糊掉的质感能补回来,原片里没有的细节它也会画出来。
它一般装在 ComfyUI 里用。在 16 GB 的 NVIDIA 显卡上,SeedVR2 3B 把一分钟 480p 视频放到 1080p 用了约 70 分钟,平均每帧 2.3 秒;同一机器的浏览器里,4K Video Upscaler 用快速档跑完同样一分钟只用了约 16 秒。要修一小段坏得厉害的片子,SeedVR2 值得等;长视频、手机,或者想让画面保持原样的,用浏览器放大更合适。
SeedVR2 是什么?
SeedVR2 用来修复和放大视频,是字节跳动 Seed 团队的研究成果,论文、代码和模型都公开了。
它是扩散模型,和 AI 画图是一类。传统的放大是把一帧里已有的像素放大;SeedVR2 参照原来的画面,在新尺寸上重新画一帧,所以能补出视频里本来没有的皮肤、头发和砖纹。它训练成了只走一步扩散就出结果。
3B 和 7B
两种大小,单位是十亿参数。3B 由 7B 蒸馏而来,不到 7B 的一半,最容易塞进家用显卡。3B 有 FP16、FP8、GGUF Q4 三种文件(6.8、3.4、2.0 GB),7B 有 FP16 和 FP8 混合两种(16.5、8.5 GB),另外都要一个 0.5 GB 的 VAE 文件。
Apache 2.0
代码和两个模型都是 Apache 2.0 许可,可以免费用、改,也可以做进收费的产品,保留许可证和声明就行。
字节官方脚本要 80 GB 的 H100
一块能处理 100 帧 720p,1080p 和 2K 要 4 块。家用显卡靠社区的 ComfyUI 节点来跑,它把活拆小了塞进显存(见下)。
SeedVR2 要多大显存?
从 480p 出 1080p、开 VAE 分块、每批 5 帧时,SeedVR2 3B(FP8)显存峰值 6.5 GB,7B(FP8)10.5 GB。把我们 16 GB 的卡限到 8 GB,VAE 分块调到 512 像素,3B 照样能跑;7B 开着 BlockSwap,限到 12 GB、8 GB 也都跑通了。
我们在搭载高端 NVIDIA 独显(RTX 30–50 系)的台式机上测,显卡有 16 GB 显存;再把同一显卡限到更少的显存,模拟 12 GB 和 8 GB 的卡。限的只是显存,所以每一行都是这张卡的速度。要多少显存,看三件事:
- 模型:3B 还是 7B,文件压缩到什么程度。
- 输出尺寸:4K 比 1080p 要多得多。
- 每批帧数:一次一起修几帧,按 4n + 1 算(1、5、9、13……);超过 5 帧,显存猛涨。
SeedVR2 分三步:VAE 先把每帧编码成紧凑的形式,DiT(真正做修复的部分)在上面修,VAE 再把结果解码成新尺寸的画面。社区节点有两个开关能把显存压下来。VAE 分块(tiling)把每帧切成小块来编码、解码;BlockSwap 把 DiT 的一部分放在内存里,用到哪块再搬上显卡。
| 模型 | 占显存 | 内存 | 每帧 |
|---|---|---|---|
| 16 GB 显存 | |||
| 3B,FP8 | 6.5 GB | 6.6 GB | 2.3 秒 |
| 3B,FP16 | 9.2 GB | 8.8 GB | 2.4 秒 |
| 7B,FP8 | 10.5 GB | 10.1 GB | 2.9 秒 |
| 7B,FP16开 BlockSwap | 5.1 GB | 30.4 GB | 5.1 秒 |
| 限到 12 GB | |||
| 3B,FP8 | 6.3 GB | 6.6 GB | 2.3 秒 |
| 3B,FP16 | 9.2 GB | 8.9 GB | 2.4 秒 |
| 7B,FP8开 BlockSwap | 5.2 GB | 17.9 GB | 3.7 秒 |
| 限到 8 GB | |||
| 3B,FP8 | 6.1 GB | 6.6 GB | 2.2 秒 |
| 3B,FP8开 BlockSwap | 3.1 GB | 8.5 GB | 2.4 秒 |
| 3B,GGUF Q4开 BlockSwap | 4.2 GB | 6.8 GB | 2.5 秒 |
| 7B,FP8开 BlockSwap | 3.0 GB | 17.8 GB | 3.7 秒 |
限到 8 GB 时,节点推荐给小显存的 GGUF 文件开着 BlockSwap 也能跑,但比 FP8 慢:每帧 2.5 秒,FP8 只要 2.2 秒。真的 8 GB 卡还要分一些给桌面;开 BlockSwap 后,3B(FP8)只占 3.1 GB,每帧 2.4 秒。
SeedVR2 显存不足、突然变慢?打开 VAE 分块
不开分块,16 GB 的卡解码 5 帧 1080p 要 21.9 GB。Windows 不会报错停下,而是把装不下的部分挪到内存里接着跑,每批 5 帧的解码就从 6 秒变成了 63 秒。跑着跑着突然慢得像卡住了,多半就是溢出了,这时打开分块、把分块调小,或者减少每批的帧数。限到 8 GB 时,默认 1024 像素的编码分块超出了上限,调到 512 像素就放得下。
每批多放几帧,速度快不了多少,显存却多占很多。每批 5、9、17 帧时,每帧分别是 2.27、2.17、2.14 秒,占显存 6.5、11.3、10.8 GB。节点的 README 说,每批和镜头一样长时前后帧最一致;在我们的片子上,每批 9 帧闪得最少,前后帧的亮度变化比原片多 0.1 级(亮度按 0–255 算);17 帧闪得最多,多 0.5 级。
长视频要设分段(chunk size)
不设分段的话,脚本会把整段视频都放在内存里,每帧 1080p 多占约 34 MB,一分钟 30 fps 就是 61 GB。设成每段 25 帧,它就一段一段地读:3B 把一分钟的 1800 帧从头跑到尾,内存最多只用了 6.6 GB。
SeedVR2 要跑多久?
SeedVR2 处理每一帧分三步:先把画面压缩成模型能处理的形式(VAE 编码),再由 3B 或 7B 模型修复、放大(DiT),最后还原成画面(VAE 解码)。在 16 GB 的卡上把一分钟 480p 视频放到 1080p,3B 平均每帧压缩 0.52 秒、修复 0.57 秒、还原 1.10 秒;1800 帧再加上调色、载入模型和读写视频,一共用了约 70 分钟。7B 只有中间修复这一步更慢,每帧 1.33 秒,所以总共只慢 36%。分段跑时,每段做完都要把模型挪出显卡、下一段再装回来,这也算在修复这一步里;7B 的模型大,挪得久,所以它的每帧比上面显存表里短片一次跑完的慢一些。
| 同一机器 | 平均每帧 | 跑完一分钟视频 |
|---|---|---|
| SeedVR2 7B(FP8) | 3.1 秒 | |
| SeedVR2 3B(FP8) | 2.3 秒 | |
| 极致 | 70 毫秒 | |
| 专业 | 38 毫秒 | |
| 快速 | 9 毫秒 |
同样一分钟的视频,SeedVR2 3B 的用时是 4K Video Upscaler 快速档的 260 倍、极致档的 32 倍。放到 4K 还要慢得多:从 720p 出发,3B 每帧要 9 秒,差不多是出 1080p 的 4 倍。这 9 秒是开着 BlockSwap、分段设为 5 帧测的;不开 BlockSwap,修 4K 的帧会把 16 GB 显存占满,每帧反而要 20 秒;不分段的话,每一批都比上一批慢,平均每帧 38 秒。
SeedVR2 效果怎么样?人脸、录像带、AI 片和文字实测
我们拿同一批片子比了普通放大、本站三档和 SeedVR2。其中仿 DVD 的人脸和仿录像带的街景是用高清电影做的,还有一段从 4K 素材压成的低码率 480p 片子、两段 AI 片和一段代码的录屏。除了 AI 片,都有原片可以对照。
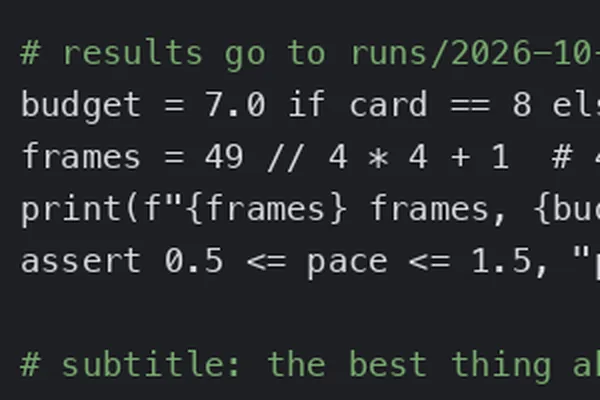
画面:《Tears of Steel》(2012,Blender Foundation),CC BY 3.0;仿 DVD、仿录像带的副本、两段 AI 片和代码录屏由我们制作。
拿原片来比,人脸和低码率片子上 SeedVR2 最像原片,街景上和普通放大打平。我们用的是 LPIPS,它学的是人眼怎么判断两张图像像不像,分数越低越像。
| 像不像(越低越像) | 仿 DVD 的人脸 | 仿录像带的街景 | 低码率的 480p 片子 |
|---|---|---|---|
| 普通放大 | 0.22 | 0.17 | 0.28 |
| 快速 | 0.24 | 0.18 | 0.27 |
| 专业 | 0.18 | 0.18 | 0.25 |
| 极致 | 0.26 | 0.24 | 0.26 |
| SeedVR2 3B | 0.14 | 0.17 | 0.20 |
| SeedVR2 7B | 0.14 | – | 0.21 |
逐个像素比,结果正好反过来。PSNR 看每个像素和原片有多接近,越高越近。三段片子里 SeedVR2 都低于普通放大、快速档和专业档,低码率片子上是 30.2 dB,快速档 32.4 dB。它画出来的细节看着对,但不是原片里的那些。
SeedVR2 一次修 5 帧,批次之间的接缝看得出来。低码率片子上,每到接缝亮度就跳一下,从上一批的最后一帧到下一批的第一帧,变化比原片多 1.1 级;同一批里面不比原片多(−0.1)。AI 动漫片上,它画的线在同一批里也一帧一个样(2.1,快速档是 0.1)。本站三档每帧单独放大,没有接缝。仿录像带的街景上雪花每帧都在变,所有结果都比普通放大闪。普通放大是 1.7 级,快速 3.2、专业 3.1、极致 5.1、SeedVR2 4.1。
SeedVR2 能补回皮肤、头发和砖墙
仿 DVD 的人脸上,SeedVR2 是我们跑过的所有方法里最接近高清原片的;仿录像带的街景上,和普通放大打平。
SeedVR2 会画出原片没有的细节
睫毛和眉毛比高清原片还锐,干净的线稿会多出线条。7B 用时多 36%;按 LPIPS,人脸上它比 3B 离原片近一点,低码率片子上远一点。
SeedVR2 会改掉小字和数字
代码录屏里,不管哪个模型,每一行都改了数字或字母;快速、专业、极致三档一个都没改。720p AI 片里烧进画面的大字幕,两个模型都没改。
怎么跑 SeedVR2?
在 ComfyUI 里装 SeedVR2
- 在 ComfyUI 的 Manager 里打开「Custom Nodes Manager」,搜「ComfyUI-SeedVR2_VideoUpscaler」并安装。
- 重启 ComfyUI。
- 把节点 example_workflows 文件夹里的示例工作流 SeedVR2_HD_video_upscale.json 拖进 ComfyUI。它已经连好了:「Load Video」→「Get Video Components」→「SeedVR2 Video Upscaler」→「Create Video」→「Save Video」,「SeedVR2 (Down)Load DiT Model」和「SeedVR2 (Down)Load VAE Model」接在放大节点的 dit、vae 输入上。
- 显存 12 GB 以上:DiT 加载节点选 3B 的 FP8 模型,VAE 加载节点打开 encode_tiled 和 decode_tiled,「SeedVR2 Video Upscaler」的 batch_size 设为 5。8 GB 的再把 encode_tile_size 和 decode_tile_size 调到 512。
- 出 4K:两个分块也调到 512,再在 DiT 加载节点开 BlockSwap,把 offload_device 选成 cpu,blocks_to_swap 设为 32(7B 设 36)。
- 运行。第一次用时模型会自己下载到 models/SEEDVR2。
ComfyUI 自己也内置了 SeedVR2 节点。
Hugging Face 下载太慢或打不开怎么办
节点默认从 Hugging Face 下载。下载太慢或连不上时,可以换到 ModelScope(魔搭):上面有同名的 numz/SeedVR2_comfyUI 仓库,我们从那里下的文件和 Hugging Face 上的逐字节一致;下好放进 ComfyUI 的 models/SEEDVR2 文件夹就行。
用命令行跑 SeedVR2
节点带一个脚本 inference_cli.py,不开 ComfyUI 的界面也能跑,我们就是用它测的。下面是 16 GB 显存的设置;8 GB 和出 4K 时加上 --vae_encode_tile_size 512 --vae_decode_tile_size 512,出 4K 再加 BlockSwap(--dit_offload_device cpu --blocks_to_swap 32 --swap_io_components),分段设为 5 帧。分段让脚本边读边处理,不用把整段视频都放进内存:
python inference_cli.py clip.mp4 --resolution 1080 --dit_model seedvr2_ema_3b_fp8_e4m3fn.safetensors --batch_size 5 --vae_encode_tiled --vae_decode_tiled --vae_decode_tile_size 768 --vae_decode_tile_overlap 96 --chunk_size 25
在线试 SeedVR2
字节 Seed 在 Hugging Face 上有演示,视频最大 720p、最长 121 帧。也有网站把它做成付费服务。
用 SeedVR2 还是浏览器放大?
一小段要修的片子用 SeedVR2
录像带雪花、压缩方块、糊掉的人脸,几秒到几分钟长,显存 8 GB 以上,而且等得起。在我们 16 GB 的卡上,出 1080p,一分钟的视频用了约 70 分钟。作者也写明,退化很重、运动很大时它会失手。
长视频用浏览器放大
一整部电影、一小时的家庭录像,在笔记本、Mac、手机或 iPad 上都能放大,免费、不用注册、不用装东西,也不上传。
人脸、线稿和文字要保持原样,用快速档
SeedVR2 会重新画,可能画得不一样;快速档只放大原有的东西。
直接试
点下面的链接,首页会带着这些设置打开,再点「选择视频」。
更新记录
- 2026 年 10 月 27 日:第一版。